Jak audytować logi serwera, by odkryć problemy z indeksowaniem SEO
Logi serwera pokazują, które adresy odwiedzają roboty wyszukiwarek i gdzie tracą czas. Dowiedz się, jak je analizować, wykrywać bariery indeksowania i ustalać kolejność napraw.
Jeśli ważne kategorie i produkty nie pojawiają się w wyszukiwarce, sprawdź najpierw, czy robot w ogóle je odwiedza. Logi serwera pozwalają odróżnić brak crawlowania od sytuacji, w której robot pobrał stronę, ale wyszukiwarka jej nie zindeksowała. W dużym serwisie pokażą też, czy ruch robotów koncentruje się na wartościowych podstronach, czy na filtrach, duplikatach i nieistniejących adresach.
Audyt wykonaj w kolejności: zbierz kompletny zestaw logów, zweryfikuj roboty, pogrupuj żądania według typów URL-i, porównaj je z listą ważnych stron, a następnie zaplanuj naprawy. Sam ranking najczęściej odwiedzanych adresów nie wystarczy. Celem jest ustalenie, które przeszkody ograniczają dostęp robotów do treści istotnych dla Twojego serwisu.
1. Czym są logi serwera i jakie dane są istotne dla SEO
Logi dostępowe to zapis żądań obsłużonych przez serwer lub warstwę pośrednią, taką jak CDN czy reverse proxy. Każdy wpis opisuje konkretne żądanie: kiedy nastąpiło, jakiego zasobu dotyczyło i jaką odpowiedź otrzymał klient. W przeciwieństwie do analityki opartej na JavaScripcie logi mogą rejestrować pobrania wykonywane przez roboty, które nie uruchamiają kodu pomiarowego.
Data, godzina i strefa czasowa — pozwalają porównać ruch z wdrożeniami, awariami i zmianami treści.
Host, ścieżka i parametry zapytania — identyfikują żądany adres, w tym filtry, sortowania i warianty domeny.
Metoda HTTP — pomaga oddzielić pobrania GET od HEAD i innych rodzajów żądań.
Status HTTP — pokazuje między innymi odpowiedzi 200, przekierowania, błędy 404, 429 oraz 5xx.
Adres IP klienta i User-Agent — służą do identyfikacji oraz weryfikacji robotów.
Czas obsługi, liczba wysłanych bajtów i status cache, jeśli są dostępne — pomagają diagnozować wolne odpowiedzi i rozróżniać zachowanie CDN od serwera źródłowego.
Log potwierdza żądanie i odpowiedź, ale nie potwierdza indeksacji. Status 200 nie oznacza, że treść została wyrenderowana, wybrana jako kanoniczna ani dodana do indeksu. Te kwestie sprawdzaj dodatkowo w Google Search Console i przez analizę odpowiedzi oraz treści strony.
Crawl budget traktuj jako praktyczne ograniczenie zasobów, które wyszukiwarka przeznacza na pobieranie serwisu, a nie stały limit widoczny w logach. Duża liczba zbędnych żądań może wskazywać marnowanie tych zasobów, ale sama nie dowodzi, że właśnie dlatego ważne strony pozostają poza indeksem. Audyt powinien sprawdzić tę zależność, zamiast zakładać ją z góry.
2. Jak uzyskać logi i przygotować je do analizy
Poproś administratora lub dostawcę infrastruktury o logi dostępowe dla wszystkich hostów obsługujących serwis. Uwzględnij domenę główną, istotne subdomeny, warianty hosta i warstwę CDN. Jeżeli CDN odpowiada z pamięci podręcznej, żądanie może nie trafić do serwera źródłowego. Analiza wyłącznie logów originu zaniży wtedy rzeczywistą liczbę odwiedzin robotów.
Na początek zbierz kilka tygodni danych, obejmujących zwykłe działanie serwisu i istotne wdrożenia. Dla rzadko odwiedzanych sekcji potrzebny może być dłuższy okres. Nie dobieraj zakresu wyłącznie do wygody eksportu: brak wizyty przez kilka dni nie jest wystarczającą podstawą do uznania strony za pomijaną.
Sprawdź, czy eksport obejmuje wszystkie instancje serwerów i kolejne pliki po rotacji.
Ustal, czy dane są pełne, czy próbkowane. Na próbce nie opieraj wniosku, że konkretny adres nie został odwiedzony.
Ujednolić trzeba strefy czasowe i format pól, zachowując oryginalne dane do kontroli.
Nie sumuj bezpośrednio logów CDN i originu: jedno żądanie może występować w obu zbiorach. Analizuj warstwy osobno lub deduplikuj wpisy przy użyciu wiarygodnego identyfikatora żądania.
Zweryfikuj źródło IP klienta. Za proxy pole z adresem zdalnym może wskazywać infrastrukturę pośrednią; korzystaj z pola klienta skonfigurowanego przez zaufaną warstwę.
Ogranicz dostęp do plików i usuń niepotrzebne dane wrażliwe. Parametry URL mogą zawierać identyfikatory, adresy e-mail lub tokeny.
Małe zbiory można wstępnie obejrzeć w arkuszu, ale duży serwis zwykle wymaga parsera logów, bazy danych lub narzędzia do ich analizy. Niezależnie od rozwiązania zachowaj możliwość przejścia od podsumowania do surowych wpisów. Dzięki temu sprawdzisz, czy nietypowy wynik jest rzeczywistym problemem, czy błędem parsowania.
3. Jak odfiltrować i zweryfikować roboty wyszukiwarek
Wyszukanie Googlebot w polu User-Agent jest dobrym filtrem wstępnym, ale nie dowodem tożsamości. Dowolny klient może wysłać taką deklarację. Oddziel więc kandydatów od zweryfikowanych robotów, a wnioski dotyczące zachowania wyszukiwarki opieraj na tej drugiej grupie.
Dla Google stosuj metody opisane w jego dokumentacji: porównanie IP z publikowanymi zakresami odpowiedniej kategorii robotów albo weryfikację DNS. W drugim wariancie wykonaj odwrotne zapytanie DNS dla IP, sprawdź zgodność końcówki nazwy hosta z oficjalnymi domenami właściwymi dla danego typu robota, a następnie rozwiąż tę nazwę ponownie na adresy IP. Wynik musi zawierać pierwotny adres. Sama obecność słowa google w nazwie hosta nie wystarcza.
Weryfikację wykonuj dla unikalnych IP, a nie dla każdego wpisu osobno. Zachowaj też informację, na jakiej podstawie adres został uznany za wiarygodny. Przy starszych logach uwzględnij ograniczenie: bieżący DNS lub bieżąca lista zakresów nie zawsze pozwolą jednoznacznie potwierdzić historyczny ruch.
Oddziel zwykłe crawlowanie Googlebota od innych robotów Google i pobrań uruchamianych przez użytkowników, na przykład podczas testowania adresu.
Analizuj osobno roboty innych wyszukiwarek; ich żądania nie świadczą o aktywności Google.
Rozdziel żądania dokumentów HTML od pobrań obrazów, skryptów i arkuszy stylów.
Nie usuwaj zasobów z audytu całkowicie: błędy ich pobierania mogą utrudniać renderowanie.
4. Jak sprawdzić, które adresy są crawlowane najczęściej
Przygotuj dwa widoki: ranking pojedynczych adresów oraz zestawienie grup URL-i. W pierwszym zlicz żądania i zapisz pierwszy oraz ostatni moment wizyty, rozkład statusów i czasy odpowiedzi. W drugim pogrupuj strony według funkcji: kategorie, produkty, artykuły, paginacja, filtry, wyszukiwarka wewnętrzna, zasoby statyczne i pozostałe.
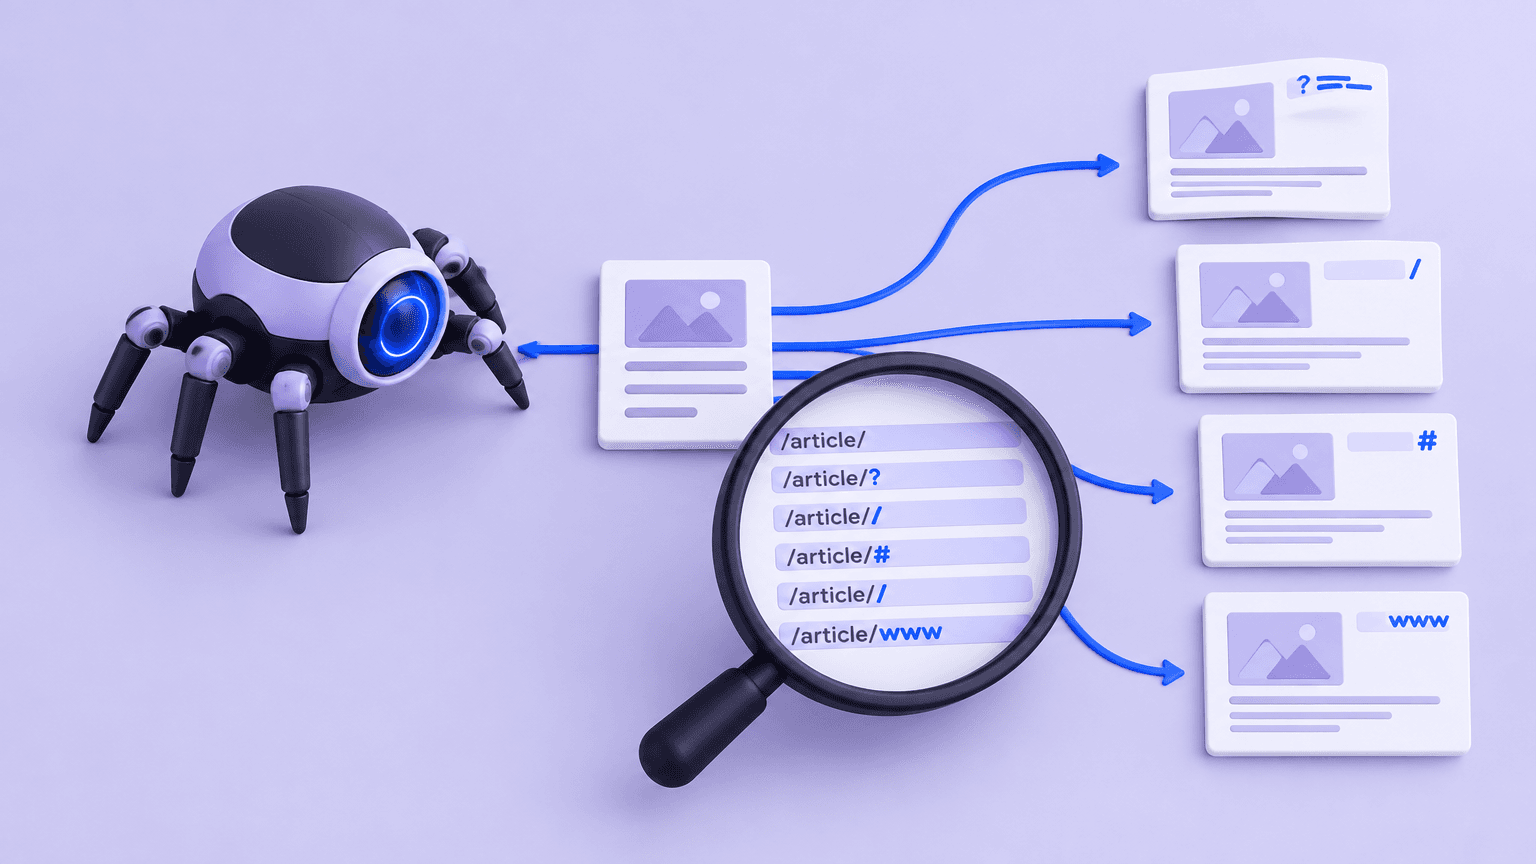
Zachowaj surowy URL oraz osobny klucz do grupowania. Nie usuwaj automatycznie wszystkich parametrów i nie zamieniaj całych ścieżek na małe litery: możesz połączyć różne zasoby. Ustal z zespołem technicznym, które parametry zmieniają treść, a które wyłącznie śledzą źródło wizyty. Fragment adresu po znaku # nie trafia w żądaniu HTTP do serwera, więc nie oczekuj go w logach.
Udział żądań do danej grupy = żądania do tej grupy podzielone przez wszystkie analizowane żądania zweryfikowanego robota.
Liczba unikalnych URL-i pokazuje skalę przestrzeni adresów; porównaj ją z liczbą stron, które rzeczywiście chcesz udostępniać do indeksowania.
Pokrycie ważnych stron = liczba ważnych URL-i odwiedzonych w badanym okresie podzielona przez liczbę wszystkich ważnych URL-i w zestawieniu.
Czas od publikacji lub aktualizacji do pierwszej zaobserwowanej wizyty wymaga połączenia logów z datami z CMS. Bez tych dat nie da się go wiarygodnie wyliczyć.
Mediana i wyższe percentyle czasu odpowiedzi pomagają wykryć problemy ukryte przez średnią; upewnij się, co dokładnie mierzy dane pole logu.
Następnie połącz logi z inwentarzem stron z CMS, mapami witryny i wynikami crawla wewnętrznego. To kluczowy moment: sam log pokazuje tylko odwiedzone zasoby. Dopiero lista oczekiwanych adresów pozwala znaleźć ważne podstrony bez zaobserwowanej wizyty. Łączenie wykonuj według spójnych zasad dotyczących protokołu, hosta, ukośnika i kodowania znaków, bez zacierania rzeczywistych różnic między adresami.
Przykład hipotetyczny: robot często pobiera kombinacje filtrów, a część aktywnych kategorii nie ma wizyt w badanym okresie. To sygnał do sprawdzenia linkowania i generowania filtrów, nie dowód na konieczność zablokowania wszystkich parametrów. Niektóre strony filtrowania mogą odpowiadać na wartościowe zapytania i celowo podlegać indeksowaniu.
5. Jak rozpoznać błędy, pułapki i niepotrzebne adresy URL
Błędy odpowiedzi i wolne pobieranie
Zacznij od 5xx, 429 i powtarzających się błędów ważnych stron. Zestaw je w czasie z ruchem, wdrożeniami i logami aplikacji. Sprawdź również WAF oraz limity żądań: zweryfikowany robot może otrzymywać 403, mimo że użytkownicy widzą poprawną stronę. Jeżeli problem dotyczy tylko części infrastruktury, średnie dla całej domeny mogą go ukryć.
Odpowiedzi 404 i 410 oceniaj według intencji. Usunięty produkt bez odpowiednika może prawidłowo zwracać błąd braku zasobu. Problemem są natomiast aktywne linki wewnętrzne i mapy witryny kierujące do takiego adresu lub błędna odpowiedź na stronie, która powinna działać. Nie przekierowuj masowo wszystkich usuniętych URL-i na stronę główną; przekierowanie powinno prowadzić do rzeczywiście odpowiadającej treści.
Przeanalizuj też często pobierane przekierowania. Pole Location nie zawsze znajduje się w logach, więc odtwórz docelowe adresy dodatkowym sprawdzeniem HTTP. Skróć łańcuchy i popraw linki wewnętrzne tak, by prowadziły bezpośrednio do celu. Odpowiedź 304 oznacza obsługę żądania warunkowego i sama w sobie nie jest błędem.
Pułapki crawlowania i mnożenie wariantów
Szukaj wzorców, które tworzą bardzo wiele unikalnych adresów przy niewielkiej wartości treści: dowolnych zakresów dat w kalendarzu, kombinacji filtrów, zmiennej kolejności parametrów, identyfikatorów sesji i zapętlonych segmentów ścieżki. Podejrzany jest zwłaszcza stały przyrost nowych wariantów, do których robot rzadko wraca. Otwórz próbki URL-i i znajdź mechanizm ich generowania w linkach, formularzach lub kodzie aplikacji.
Nie uznawaj automatycznie całej paginacji za zbędną. Może być drogą odkrywania produktów i starszych publikacji. Najpierw sprawdź, czy po jej ograniczeniu robot nadal dotrze do istotnych elementów katalogu. Podobnie canonical może pomagać konsolidować duplikaty, ale nie blokuje ich pobierania i pozostaje wskazówką, a nie bezwarunkowym poleceniem.
Strony z odpowiedzią 200, których indeksacja nadal zawodzi
Dla ważnych URL-i regularnie odwiedzanych z odpowiedzią 200 sprawdź dyrektywy meta robots i X-Robots-Tag, canonical, treść widoczną po renderowaniu oraz podobieństwo do innych stron. Logi zwykle nie zawierają tych informacji. Pozornie poprawna odpowiedź może kryć pusty szablon, komunikat o braku produktu albo stronę błędu zwróconą jako 200, czyli sytuację wymagającą oceny pod kątem soft 404.
Nie myl ograniczania crawlowania z usuwaniem z indeksu. Disallow w robots.txt nie gwarantuje deindeksacji. Aby robot odczytał noindex, musi mieć dostęp do odpowiedzi strony. Nie blokuj więc pochopnie adresów, na których wyszukiwarka powinna najpierw zobaczyć tę dyrektywę.
6. Jak przełożyć analizę na priorytetowy plan napraw
Każde ustalenie zamień w zadanie zawierające wzorzec URL-i, dowód z logów, znaczenie danej grupy stron, proponowaną zmianę i sposób weryfikacji. Priorytet powinien wynikać z wpływu na ważne treści, zasięgu problemu i pewności diagnozy, a nie tylko z liczby żądań. Uwzględnij też koszt oraz ryzyko wdrożenia.
Najpierw przywróć dostęp: usuń przypadkowe blokady robotów, błędy 5xx, niewłaściwe 429 i awarie kluczowych szablonów. Kryterium odbioru to poprawne odpowiedzi w testach i kolejnych wizytach zweryfikowanego robota.
Następnie napraw odkrywanie ważnych stron: popraw linkowanie wewnętrzne, usuń osierocenie i uporządkuj mapy witryny tak, by zawierały docelowe, kanoniczne URL-e przeznaczone do indeksowania.
Ogranicz źródła zbędnych adresów: usuń identyfikatory sesji z linków, napraw generowanie filtrów i kalendarzy oraz kieruj odnośniki do właściwych wariantów. Zacznij od źródła mnożenia URL-i.
Uporządkuj sygnały indeksowania: skoryguj błędny noindex, canonical, soft 404 i przekierowania. Dobieraj rozwiązanie do tego, czy strona ma pozostać dostępna, zniknąć czy zostać zastąpiona.
Na końcu dopracuj mniej pilne nieefektywności, takie jak sporadycznie odwiedzane historyczne adresy, jeśli nie utrudniają dostępu do istotnej części serwisu.
Przykład hipotetyczny: z logów wynika, że linki do sortowania generują wiele wariantów kategorii. Zadanie nie powinno brzmieć poprawić crawl budget. Zapisz konkretnie: ustalić wariant docelowy, ograniczyć generowanie zbędnych odnośników, sprawdzić spójność canonical i przetestować wybraną kategorię. Osobno określ, które filtry mają pozostać stronami docelowymi z własną wartością.
7. Jak sprawdzić, czy naprawy rzeczywiście pomagają
Przed wdrożeniem zapisz stan bazowy i datę zmiany. Po wdrożeniu porównaj okresy o podobnej długości, uwzględniając sezonowość, wielkość katalogu oraz awarie. Monitoruj udział żądań do zbędnych wariantów, pokrycie ważnych URL-i, błędy odpowiedzi i opóźnienie pierwszej wizyty po publikacji. Sam spadek łącznej liczby żądań nie musi oznaczać poprawy — może też wynikać z utrudnionego dostępu.
Efekt w logach zestawiaj z raportami indeksowania i kontrolą reprezentatywnych URL-i w Google Search Console. Wizyta robota po naprawie potwierdza ponowne pobranie, nie gwarantuje indeksacji ani wzrostu widoczności. Jeśli ważne strony są pobierane poprawnie, ale pozostają poza indeksem, kolejny etap to ocena ich treści, duplikacji i sygnałów kanonicznych, a nie dalsze ograniczanie ruchu robota.
Zacznij od jednej ważnej sekcji serwisu. Przygotuj listę jej docelowych URL-i, połącz ją ze zweryfikowanymi wizytami robota i oznacz trzy grupy: bez zaobserwowanej wizyty, odwiedzane z błędem oraz odwiedzane poprawnie, lecz wymagające sprawdzenia indeksacji. Do każdej grupy przypisz konkretną diagnostykę i właściciela zadania. Taki zakres pozwoli przetestować metodę, zanim obejmiesz audytem cały serwis.