Jak zoptymalizować paginację w SEO, by roboty i użytkownicy trafiali do właściwych produktów
Paginacja może utrudniać odkrywanie produktów i marnować zasoby indeksowania, jeśli jej konfiguracja nie odpowiada strukturze sklepu. Sprawdź, jak dobrać linkowanie, adresy URL i sygnały indeksowania do konkretnych potrzeb serwisu.
Jeśli kolejne strony kategorii pokazują inne produkty, zazwyczaj warto udostępnić je robotom, połączyć zwykłymi linkami i nadać każdej własny adres kanoniczny. Nie przekierowuj automatycznie całej paginacji na pierwszą stronę i nie ustawiaj dla niej zbiorczo noindex. Najpierw sprawdź, czy to właśnie przez kolejne strony kategorii wyszukiwarka dociera do istotnej części asortymentu.
Najważniejsza decyzja nie brzmi jednak: indeksować czy nie indeksować każdą stronę. Trzeba rozdzielić trzy kwestie: możliwość pobrania adresu przez robota, zgodę na jego indeksowanie oraz dostępność produktów przez linki wewnętrzne. Dobrze zaprojektowana paginacja wspiera te cele, ale nie wymaga, by każda jej strona pojawiała się w wynikach wyszukiwania.
Jak paginacja wpływa na odkrywanie produktów i indeksowanie
Paginacja dzieli listę produktów na osobne adresy, na przykład /buty/ oraz /buty/?page=2. Dla robota są to różne strony, z których każda może prowadzić do innego zestawu kart produktów. Jeżeli link do produktu występuje wyłącznie na dalszej stronie kategorii, dostępność tej strony ma znaczenie dla jego odkrycia i ponownych odwiedzin.
Głębokość kliknięć to liczba przejść potrzebnych do dotarcia do adresu z ważnych punktów serwisu. Gdy jedyna droga do produktu prowadzi przez kilkanaście kolejnych przycisków następnej strony, architektura sklepu utrudnia jego odnalezienie. Nie istnieje jedna bezpieczna liczba poziomów dla każdego sklepu. Problemem jest przede wszystkim brak alternatywnych, sensownych ścieżek do asortymentu.
Odkrycie adresu: robot znajduje link do produktu lub otrzymuje jego adres z mapy witryny.
Pobranie strony: robot odwiedza adres, o ile pozwalają na to reguły dostępu i jego własne decyzje dotyczące skanowania.
Indeksowanie: wyszukiwarka ocenia stronę i decyduje, czy uwzględnić ją w indeksie.
Widoczność: zaindeksowany produkt może pojawiać się na odpowiednie zapytania, ale samo indeksowanie nie gwarantuje pozycji.
Mapa XML z adresami produktów pomaga w ich odkrywaniu, lecz nie zastępuje nawigacji. Karta produktu powinna być osiągalna także przez linki w serwisie. Jeśli mapa XML jest jedynym źródłem jej adresu, warto sprawdzić kategorie, podkategorie i inne trwałe powiązania z ofertą.
Kiedy strony paginacji powinny być dostępne dla robotów
Dla podstawowej listy kategorii bez dodatkowych filtrów rozsądnym punktem wyjścia jest dostępne skanowanie i brak dyrektywy noindex na kolejnych stronach. Każda z nich powinna przedstawiać rzeczywistą część oferty, zwracać prawidłową odpowiedź i mieć własny canonical. Wyszukiwarka nadal może uznać, że nie wszystkie takie strony warto indeksować. Sam brak indeksacji strony numer osiem nie świadczy jeszcze o awarii.
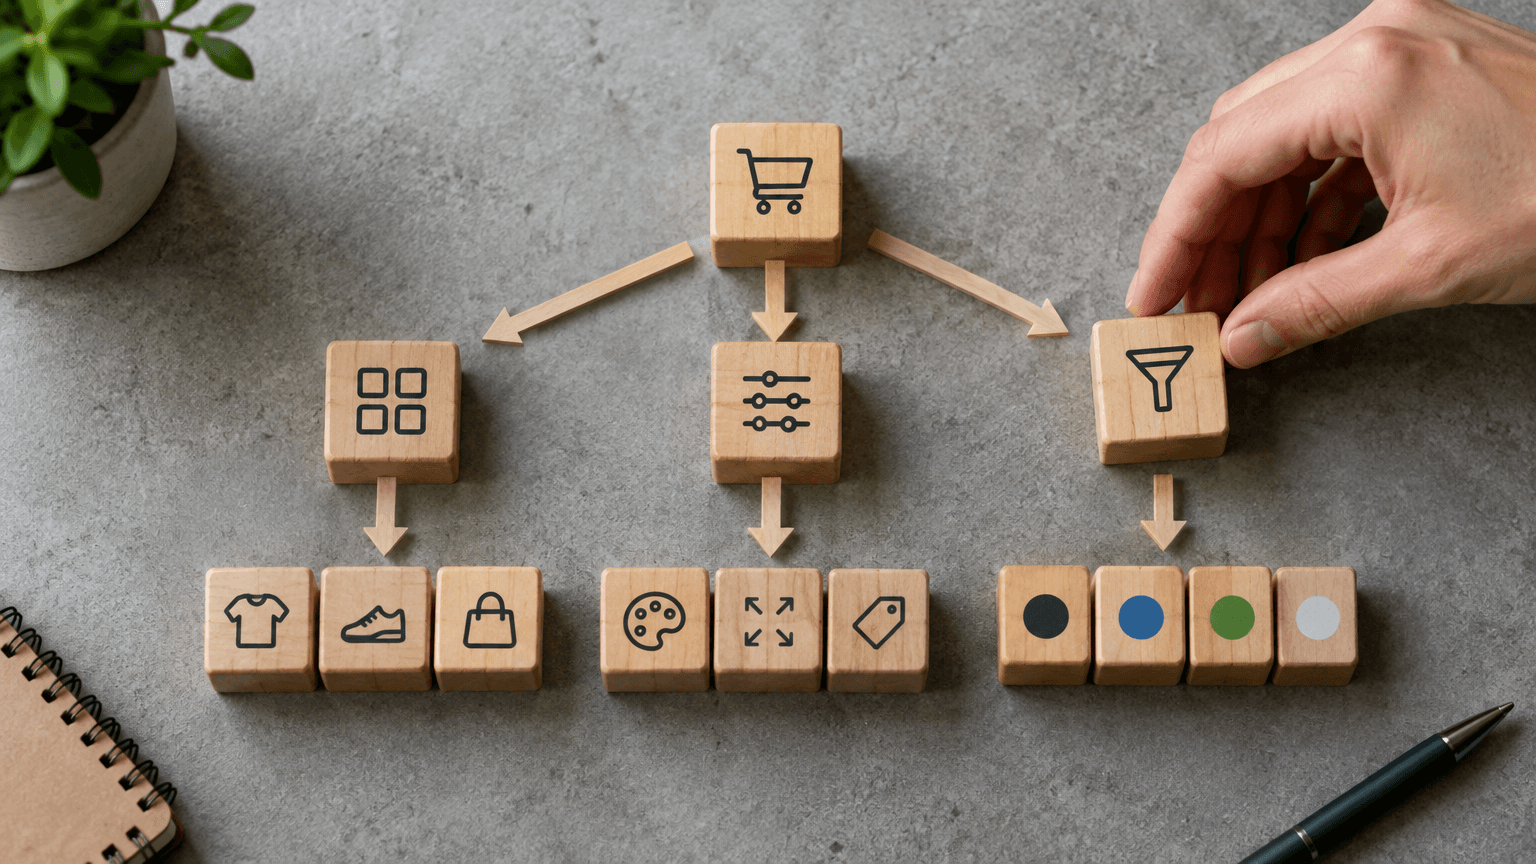
Schemat decyzji dla kategorii, filtrów i wariantów listy
Czy adres pokazuje kolejny, odmienny zestaw produktów w podstawowej kategorii? Udostępnij go robotom i zwykle zastosuj canonical wskazujący ten sam adres.
Czy adres jest tylko drugim zapisem tej samej strony, na przykład /buty/?page=1 zamiast /buty/? Ujednolić go można przekierowaniem do adresu podstawowego i konsekwentnym linkowaniem.
Czy lista powstała przez zmianę sortowania? Potraktuj ją jako wariant listy, a nie nową kategorię SEO. Dobierz sposób ograniczania indeksowania do rzeczywistej zawartości i działania serwisu.
Czy filtr tworzy przydatną, trwałą kategorię odpowiadającą konkretnej potrzebie zakupowej? Może zasługiwać na własną stronę indeksowalną, wraz z dostępną paginacją.
Czy kombinacje filtrów tworzą mnóstwo mało użytecznych adresów? Ogranicz ich generowanie i linkowanie, zamiast blokować przy okazji podstawowe strony kategorii.
Nie kieruj canonical ze wszystkich stron paginacji na stronę pierwszą tylko dlatego, że mają podobny układ, nagłówek i opis kategorii. Inny zestaw produktów oznacza inną zawartość listy. Canonical służy wskazywaniu preferowanej wersji treści identycznej lub bardzo podobnej, a nie oznaczaniu strony najważniejszej w nawigacji. Błędna konsolidacja może utrudnić wyszukiwarce prawidłową interpretację kolejnych stron.
robots.txt, noindex i canonical nie są zamiennikami. robots.txt ogranicza pobieranie strony, ale sam nie gwarantuje usunięcia jej adresu z indeksu. Aby odczytać noindex, robot musi móc pobrać stronę. Canonical jest sygnałem wyboru preferowanej wersji, nie zakazem indeksowania.
Noindex na paginacji można rozważyć, jeśli celowo nie chcesz tych list w wynikach i zapewniasz produktom inne, trwałe ścieżki dostępu. Nie traktuj jednak połączenia noindex i follow jako gwarancji stałego odkrywania produktów przez te strony. W dłuższej perspektywie wyszukiwarka może rzadziej je odwiedzać. Jeśli problemem jest nadmiar skanowania, samo noindex go nie rozwiązuje, ponieważ dyrektywę trzeba najpierw odczytać.
Jak projektować adresy URL, linki i nawigację między stronami
Wybierz jeden przewidywalny format adresów, na przykład /buty/?page=2 albo /buty/strona/2/. Sam wybór parametru lub ścieżki nie przesądza o skuteczności SEO. Ważniejsze są spójność, brak zbędnych wariantów i poprawna obsługa każdego adresu. Numer strony powinien prowadzić do określonej części listy również po bezpośrednim otwarciu adresu, bez wcześniejszej wizyty w kategorii.
Linkuj za pomocą elementów a z atrybutem href. Sam przycisk uruchamiający JavaScript nie zastępuje odnośnika do kolejnej strony.
Zapewnij przejście do poprzedniej i następnej strony, gdy istnieją. W rozbudowanych kategoriach dodaj rozsądny wybór numerów, zamiast setek linków w jednym bloku.
Wskaż użytkownikowi bieżącą stronę i nadaj linkom zrozumiałe etykiety. Dla aktywnej pozycji można zastosować aria-current="page".
Nie dodawaj nofollow do zwykłych linków paginacji, jeśli zależy Ci na odkrywaniu kolejnych części listy.
Ujednolić należy także kolejność parametrów i sposób zapisywania pierwszej strony, aby nie mnożyć adresów o tej samej zawartości.
Każdy istniejący adres paginacji powinien zwracać status 200 i właściwe produkty. Adres z numerem poza zakresem powinien zwykle zwracać 404, zamiast pustej strony z kodem 200 lub przekierowania na początek kategorii. Po zmianie liczby produktów aktualizuj nawigację, aby nie prowadziła do nieistniejących stron.
Zadbaj o stabilne sortowanie domyślne. Przy równej wartości głównego kryterium system powinien mieć dodatkowe kryterium rozstrzygające kolejność. W przeciwnym razie produkty mogą przeskakiwać między stronami nawet bez istotnej zmiany oferty. Przy dynamicznym katalogu całkowita niezmienność nie zawsze jest możliwa, ale warto ograniczyć duplikowanie i pomijanie pozycji podczas przeglądania.
Tytuł dokumentu może zawierać nazwę kategorii i numer kolejnej strony, co ułatwia orientację. Nie trzeba natomiast pisać osobnego tekstu SEO dla każdej części listy. Rozbudowany opis kategorii zwykle najlepiej wyeksponować na stronie pierwszej, a na dalszych zachować kontekst i dostęp do produktów. Google nie wykorzystuje rel="next" i rel="prev" jako sygnału indeksowania, więc ich obecność nie zastąpi prawidłowych linków i adresów.
Co zrobić z produktami na głębokich stronach kategorii
Jeżeli ważny produkt znajduje się dopiero na odległej stronie ogólnej kategorii, nie zaczynaj od blokowania paginacji. Sprawdź, czy struktura sklepu odpowiada sposobowi szukania oferty. Uzasadnione podkategorie, takie jak rodzaj produktu lub zastosowanie, skracają drogę zarówno użytkownikowi, jak i robotowi. Muszą jednak pomagać w wyborze, a nie być pustymi stronami utworzonymi wyłącznie pod frazy.
Przykład hipotetyczny: sklep umieszcza wszystkie lampy w jednej kategorii, a kinkiety trafiają na jej dalekie strony. Osobna, dostępna z menu podkategoria kinkietów może zapewnić im znacznie krótszą ścieżkę dostępu. To bardziej użyteczna zmiana niż próba wymuszenia indeksowania każdej głębokiej strony ogólnej listy.
Ważne produkty można dodatkowo łączyć przez trafne zestawienia, kolekcje i rekomendacje. Zwiększenie liczby produktów na stronie także skraca paginację, lecz ma koszt: większe obciążenie przeglądarki, transferu i renderowania. Dobierz wielkość listy po testach na urządzeniach mobilnych, zamiast stosować jedną arbitralną liczbę dla całego sklepu.
Paginacja a infinite scroll i przycisk wczytaj więcej
Automatyczne doładowywanie listy i przycisk wczytaj więcej mogą współistnieć z paginacją. Najbezpieczniejszy model opiera się na osobnych, działających adresach kolejnych części listy, a JavaScript jedynie usprawnia ich prezentację. Nie zakładaj, że robot przewinie stronę lub naciśnie przycisk, aby odkryć resztę produktów.
Każda kolejna porcja produktów ma własny URL, który można otworzyć bezpośrednio.
Pod adresem danej strony dostępne są właściwe produkty oraz linki prowadzące dalej. Renderowanie po stronie serwera może uprościć zapewnienie tej dostępności.
Interfejs doładowujący zawartość ma alternatywną ścieżkę opartą na zwykłych linkach, dostępną nie tylko po interakcji.
Jeśli adres w pasku zmienia się podczas przeglądania, odpowiada widocznej części listy, a odświeżenie strony nie przenosi użytkownika na początek.
Przycisk Wstecz odtwarza sensowny stan listy po powrocie z karty produktu; doładowanie nie gubi też fokusu klawiatury.
Infinite scroll utrudnia dotarcie do stopki i ocenę długości listy. Przycisk doładowania daje użytkownikowi większą kontrolę, a klasyczne numery stron pozwalają łatwiej wrócić do konkretnego fragmentu. Wybór interfejsu powinien uwzględniać sposób zakupów i dostępność. Dla SEO kluczowe pozostaje to, czy za interfejsem istnieje kompletna, osiągalna struktura adresów.
Lista kontrolna: jak przetestować paginację w sklepie
Wybierz do testu małą kategorię, kategorię z wieloma stronami oraz listę z filtrami. Sprawdź stronę pierwszą, drugą, jedną ze środka, ostatnią i numer poza zakresem. Osobno oceń wersję mobilną oraz wariant z doładowywaniem produktów, jeśli sklep go używa.
Dostęp z linków: czy crawler startujący od kategorii odnajduje dalsze strony i karty produktów bez korzystania z mapy XML?
Odpowiedzi serwera: czy istniejące strony zwracają 200, a adresy poza zakresem są poprawnie obsługiwane bez pustych list udających pełne strony?
Dyrektywy: czy robots.txt, meta robots i nagłówki X-Robots-Tag nie blokują przypadkowo podstawowej paginacji?
Canonical: czy każda odrębna strona listy wskazuje właściwy adres, zamiast zbiorczo wskazywać pierwszą stronę?
Treść i renderowanie: czy bezpośrednie otwarcie dalszego URL pokazuje odpowiedni zestaw produktów? Porównaj kod odpowiedzi z wyrenderowaną stroną.
Nawigacja: czy linki mają href, nie prowadzą w pętlę i nie generują kolejnych numerów po końcu listy?
Parametry: czy sortowanie, filtry i parametry śledzące nie tworzą niekontrolowanej liczby kombinacji?
Dostępność oferty: czy ważne produkty mają linki z właściwych kategorii, a nie tylko z głębokiej paginacji lub mapy witryny?
Obsługa użytkownika: czy działają powrót z produktu, odświeżenie adresu, klawiatura i zachowanie wybranych filtrów?
W Google Search Console użyj inspekcji przykładowych adresów, aby sprawdzić dostępność, stan indeksowania oraz canonical zadeklarowany i wybrany przez Google, jeśli te dane są dostępne. Test aktualnej strony pomaga ocenić jej bieżącą dostępność, ale nie obiecuje indeksacji. Raporty analizuj także dla kart produktów: celem jest dostęp do oferty, nie maksymalna liczba zaindeksowanych list.
Jeśli masz logi serwera, sprawdź, które części paginacji odwiedzają zweryfikowane roboty i czy nie poświęcają nadmiernej uwagi kombinacjom parametrów. Brak odwiedzin głębokich stron może wskazywać na słabe linkowanie, ale sam w sobie nie dowodzi jednej przyczyny. Zestaw go z wynikami crawla, stanem produktów i historią zmian wdrożenia.
Zacznij od audytu jednej dużej kategorii. Usuń błędne blokady i canonicale, zapewnij działające linki do wszystkich części listy, a następnie sprawdź dostęp do produktów. Dopiero na tej podstawie zdecyduj, czy potrzebujesz zmian w podkategoriach, filtrach lub interfejsie doładowywania.